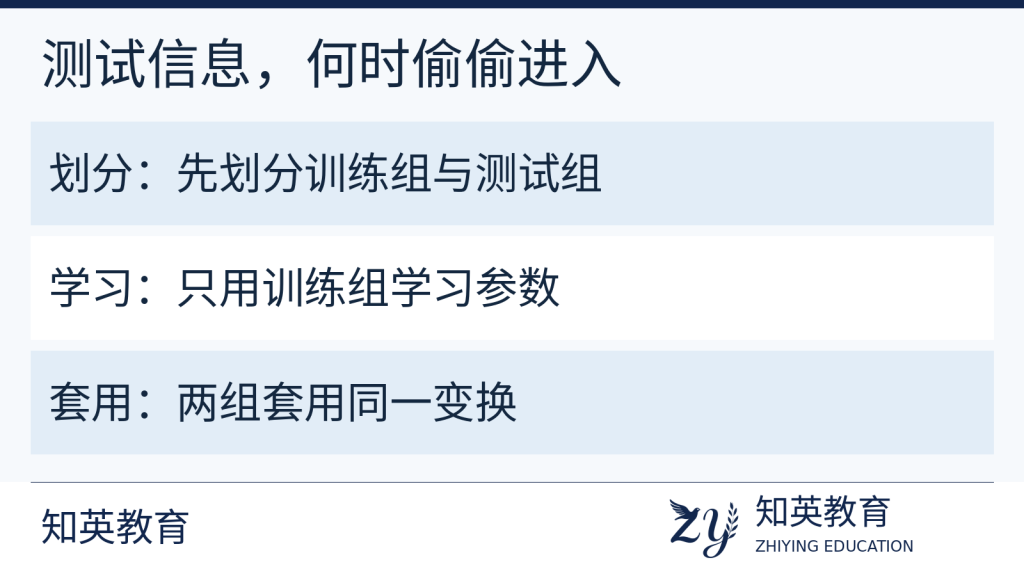
机器学习数据泄漏不一定是“把答案标签交给模型”。做独立留出测试时,如果先用全部样本计算标准化参数,再划分训练集与测试集,测试信息已经参与了准备过程。较稳妥的顺序是先划分,仅从训练集估计参数,再将同一变换用于训练集与测试集。
先区分“学参数”和“套用参数”
在软考AI基础学习中,遇到一段数据处理流程,不要只看最后有没有测试集,还要沿着均值、标准差等数值往前追:它们是从哪一组数据算出来的?测试集承担独立检查的角色,不能提前参与这类学习。
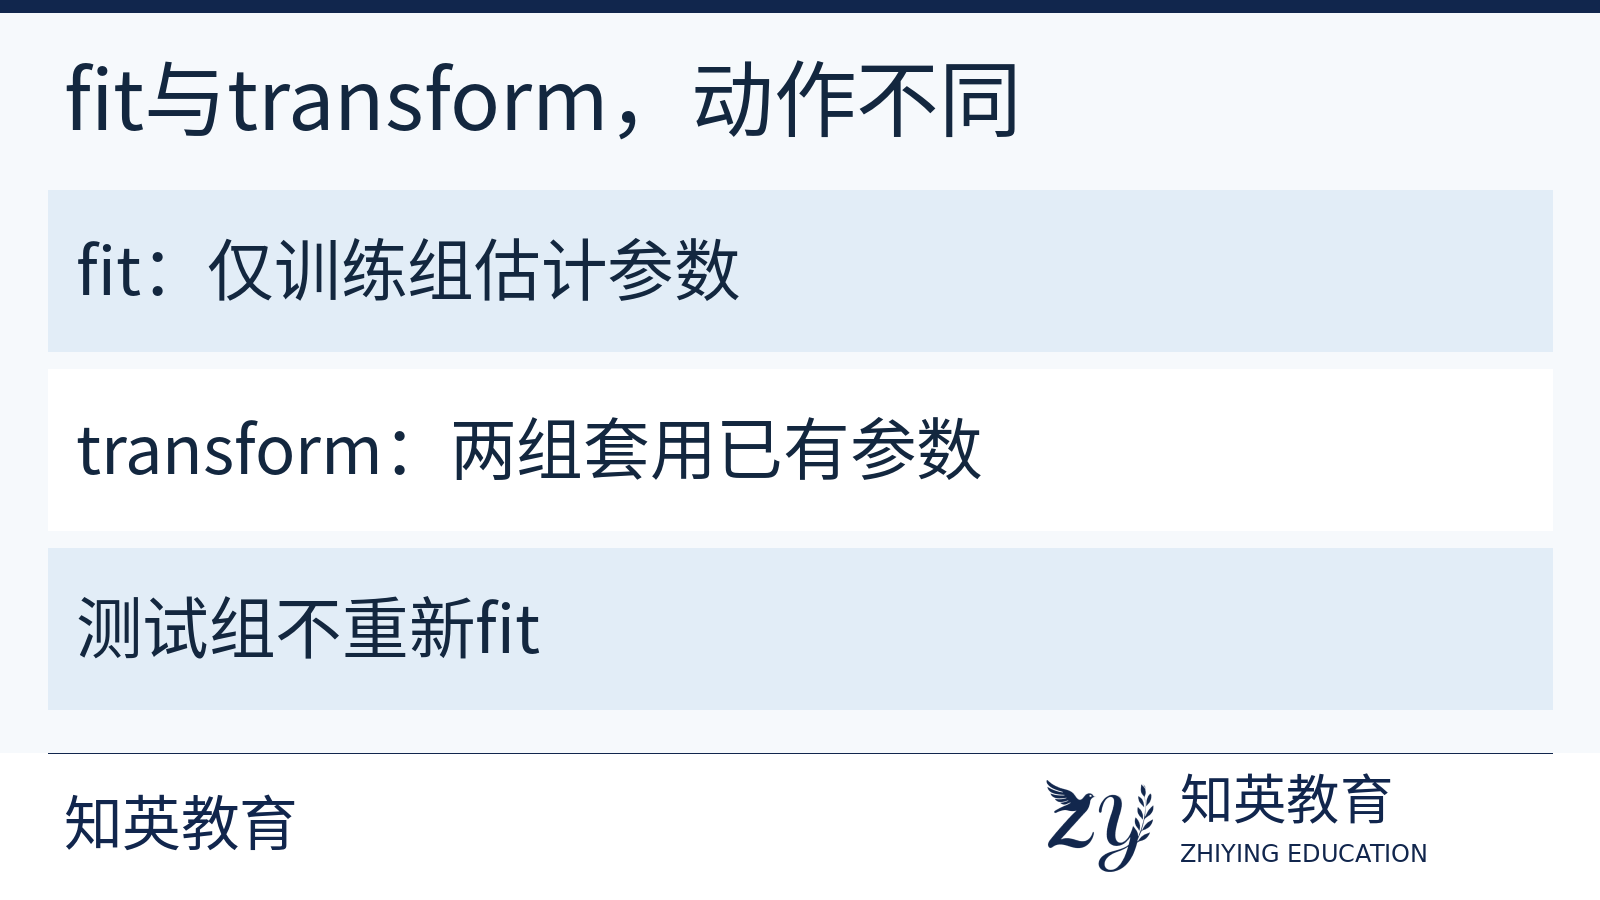
以常见标准化为例,z=(x-均值)/标准差。这里学习参数,是算出将使用的均值与标准差;套用参数,是拿已经确定的数值处理新的x。scikit-learn分别用fit和transform表示这两种动作,fit_transform则把学习与套用连在一起。
知英教育建议把这几个动作写成中文再读流程:划分、只从训练组学习、对两组套同一规则、训练模型、最后评估。术语看懂后,才不会把“测试集也需要处理”误解为“测试集也要再学习一遍”。
四个数,算清同一把尺子怎样用
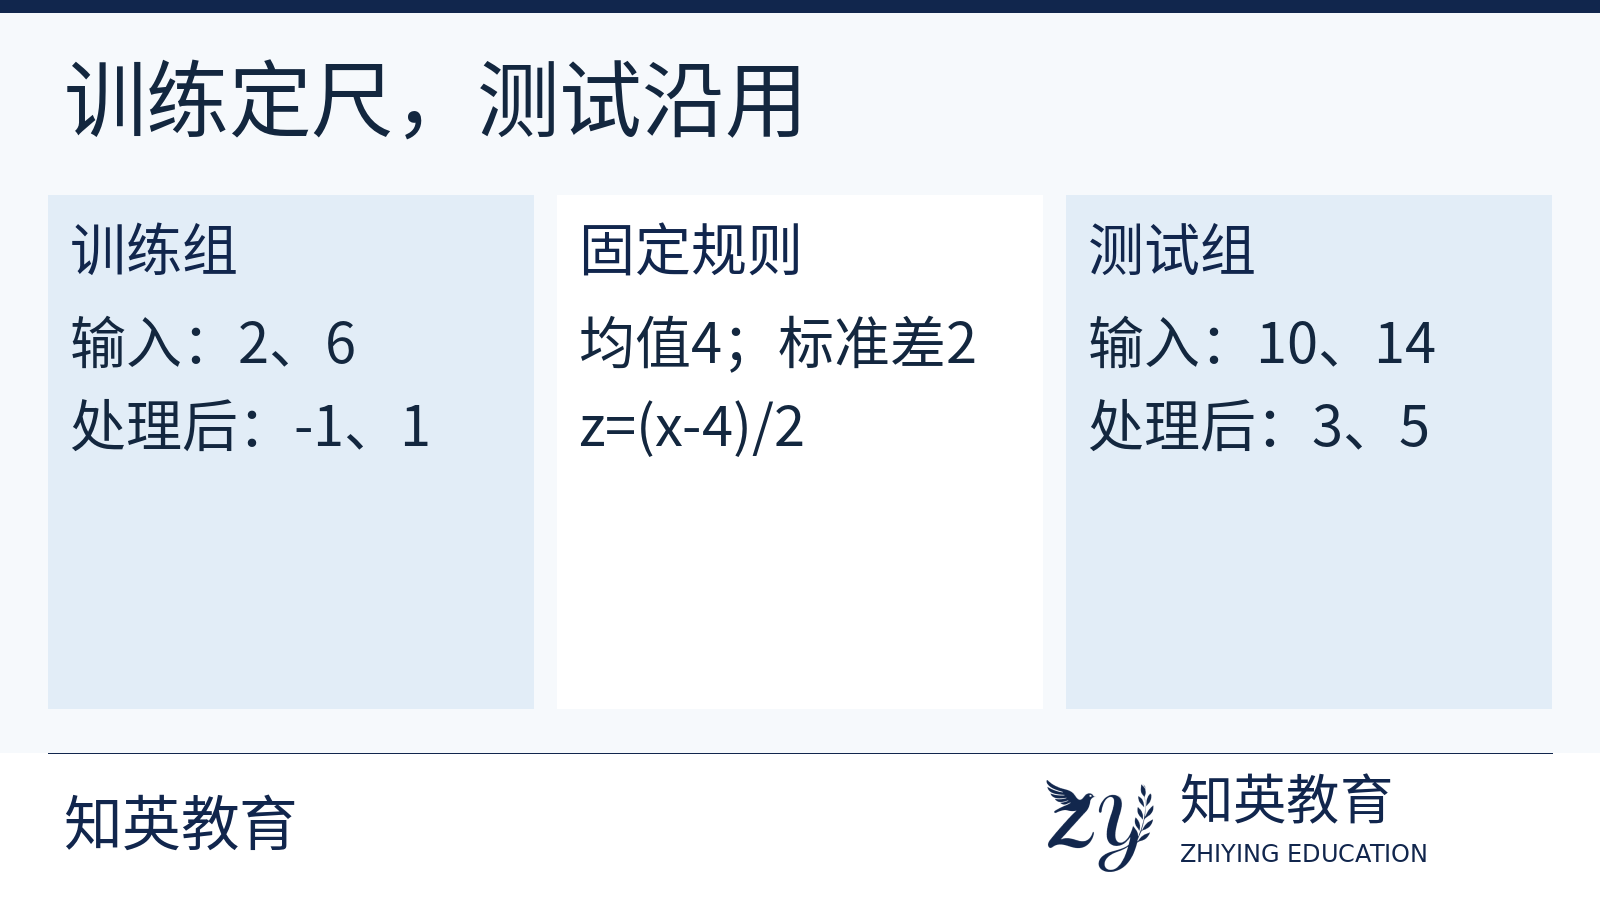
以下数据完全为教学自编,没有客户信息、真实业务指标或考试原题。只演示一个数值特征,事先已分好训练值2、6,测试值10、14;不据此讨论任何模型准确率。
采用StandardScaler默认的方差口径,即平方差平均时除以本组样本数n。训练均值=(2+6)/2=4,方差=[(2-4)²+(6-4)²]/2=4,标准差=2。由训练组得到的变换就是z=(x-4)/2。
- 训练值2变为-1,训练值6变为1。
- 测试值10变为3,测试值14变为5。
测试结果没有落在-1到1之间并不表示算错。测试值不必恰好以训练均值为中心,也不必在同一个数值范围内;关键是使用了同一组参数。
机器学习数据泄漏为什么不一定涉及标签
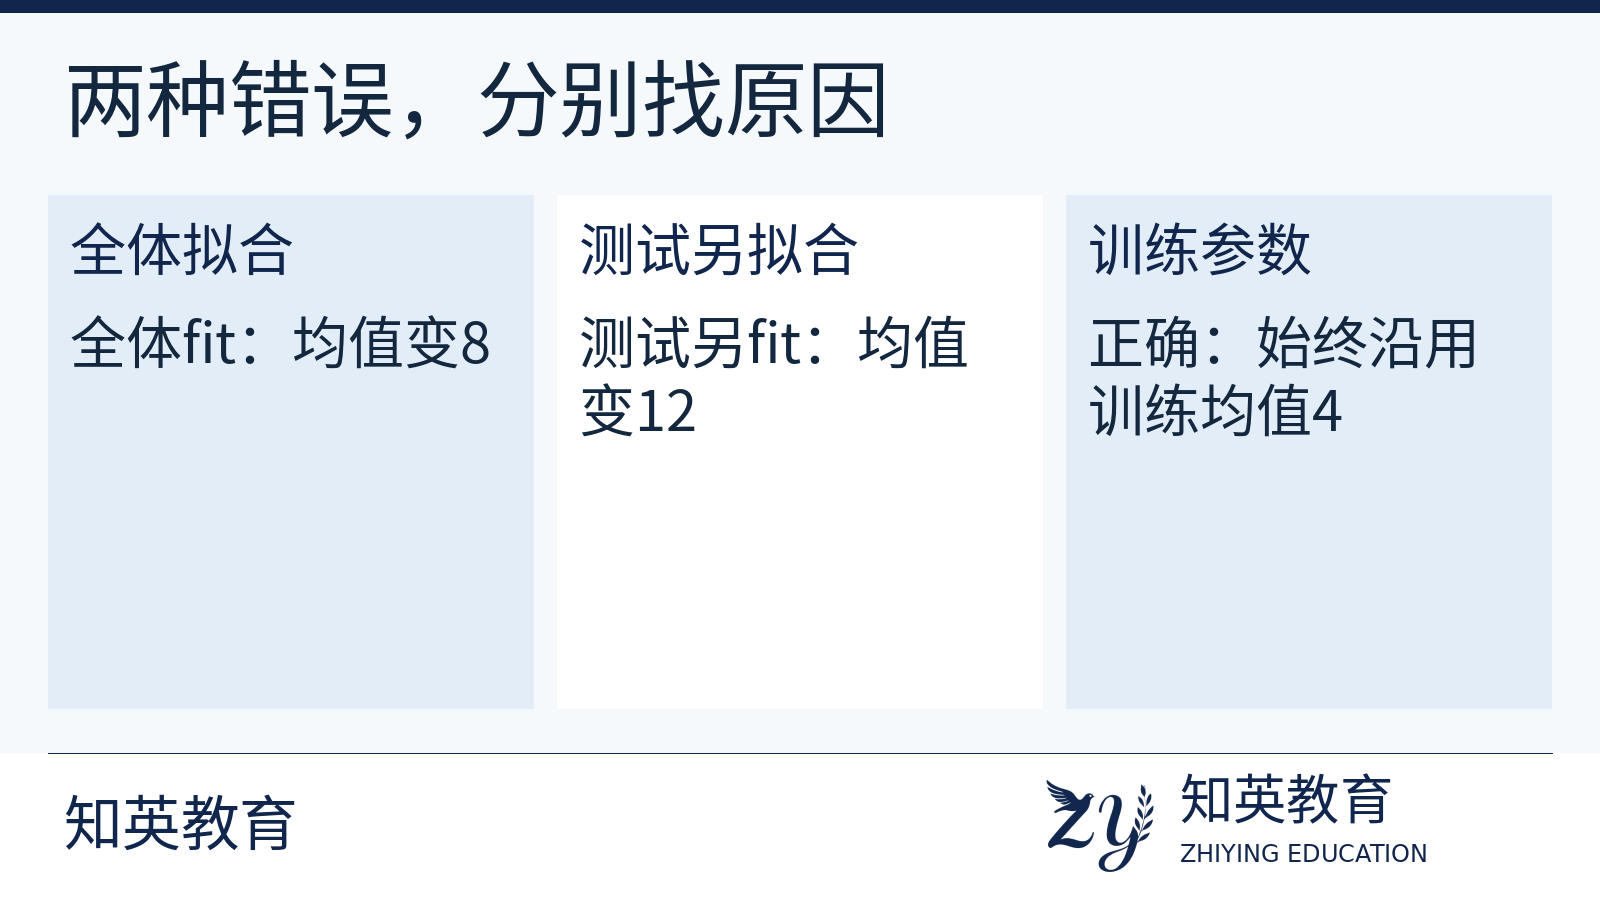
如果把2、6、10、14一起用于学习标准化参数,全体均值会变为8,方差为20,标准差为√20。这样一来,连训练值2和6的表示也会受测试值10和14影响。测试组虽然没把标签交出来,却已经改变了训练前的变换规则。
另一个常见错误是先划分,但在测试值10、14上另算一套参数。测试均值12、标准差2,于是它们也变成-1、1。数值看着整齐,两组却各用一把尺子:原来测试值高于训练值的差异被重新居中了。这属于变换不一致,不能当作正确流程的替代方案。
知英教育建议把这两种错误分开记:全数据参与拟合,是测试信息提前进入准备过程;测试集单独拟合,是把训练时约定的变换换掉。仅说“标准化放在划分之后”,仍不足以排除第二种错误。
分数更高,不能替代流程检查
scikit-learn官方常见陷阱章节提醒,泄漏可能使评估过于乐观。这里的意思是评估失去应有的独立性,不是声称每一组数据、每一种模型的分数都会按同一方向变化。
学习时可以给每个“学习参数”的步骤列出输入数据范围。均值、缺失值填补参数、特征选择等如果需要从样本估计,都要检查测试信息是否被提前使用。本文聚焦普通独立留出测试的标准化,不把两组演示直接套到全部时序、分组或其他评估设计;是否需要标准化,也应结合算法和题设判断。
复盘机器学习数据泄漏时,保留原来的处理顺序、参数来源与自己的计算,比只记一条口诀更有效。可先通过软考学习指南整理目标方向和基础差距,再经联系咨询向知英教育描述需要讲解的步骤。可协助理解基础概念与安排练习,具体课程范围以确认的信息为准,不据此承诺考试、就业或政策办理结果。
资料核对日期:2026年10月31日。技术依据为scikit-learn官方1.9.1文档中的预处理、数据泄漏与StandardScaler说明。上述四个数及计算为原创教学例;本篇未将机器学习内容称作当期软考新增或必考要求。